地质资料管理的四件难事
地质资料从汇交到利用,卡点很少在「有没有系统」,而多在这几处:
- 报盘数据进不来:汇交人交来的是报盘 XML,馆里还要重新著录一遍,重复劳动且容易串行;
- 目录与电子文件对不上:件序号、电子文件名、页数各说各话,查一份资料要开三张表;
- 查得到、借不走:检索、审批、借出、归还散在纸单与聊天记录里,超期没人提醒;
- 纸质原件找不到:库房、排架、柜层位没有台账,检查要材料只能翻箱倒柜。
本平台把这四件事连成一条链路:报盘导入 → 著录复核 → 检索预览 → 借阅审批 → 库房定位,每一步都留记录。
一条资料的完整走法
| 环节 | 做什么 | 平台模块 |
|---|---|---|
| 接收 | 汇交与移交资料登记,生成接收单、交接凭证 | 资料接收与验收 |
| 著录 | 案卷级、文件级两级目录,电子文件挂接,件序号校验 | 资料收整 |
| 检索 | 全库关键词、组合条件、空间范围三种方式 | 检索阅览 |
| 利用 | 加入借阅车 → 申请 → 两级审批 → 借出与归还 | 利用服务 |
| 保管 | 到期提醒、密级与保护期、鉴定审批、销毁与还原 | 馆藏保管 |
| 存放 | 库房 → 排架 → 柜 → 层 → 位,上下架与盘点、温湿度 | 实体库房 |
| 汇交 | 汇交单与报盘生成、馆际共享、离线目录导入、移交统计 | 汇交共享 |
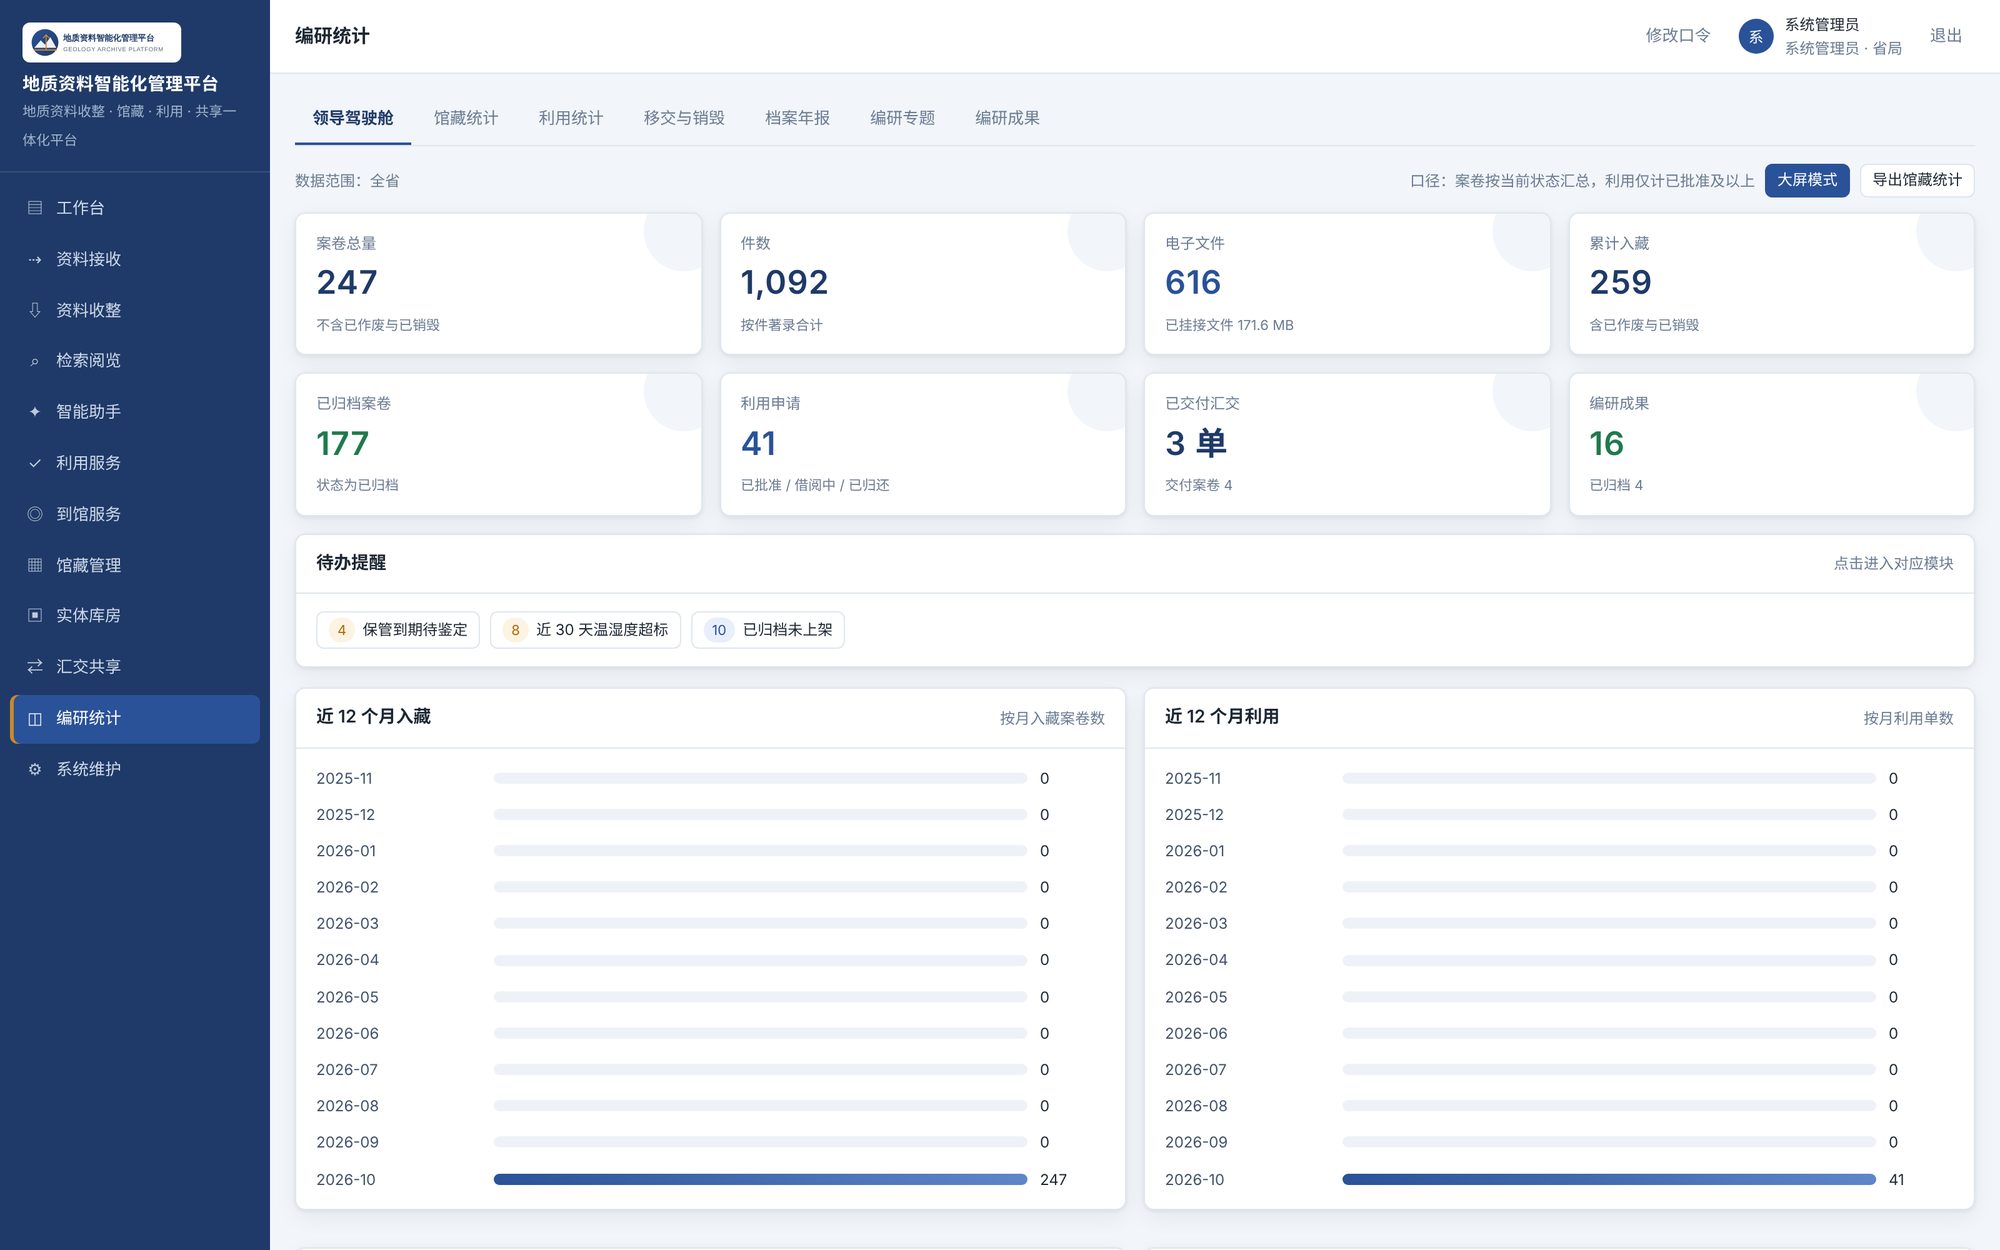
| 编研 | 专题、素材、成果,统计报表、档案年报、驾驶舱 | 编研统计 |
| 实物 | 岩心、标本、光薄片的借出与归还 | 实物利用 |
报盘导入:先预览,再落库
汇交报盘 XML 解析后先进入预览:逐卷显示可落库的案卷与件、缺字段与格式告警,确认后才写入档案库,避免把错数据灌进库再回头清理。
XML 标签到案卷/件字段的映射写在配置文件里(templates/baopan-map.json),字段口径调整只改配置;295 个报盘标签的中文名字典随包提供,客方核对字段时有据可查。著录口径(类别代码、电子文件命名、格式白名单、dpi 下限)另有一份标准文件约束,前端保存时即时校验。
检索与借阅:权限按全宗收口
- 三种检索:全库关键词、组合条件(资料类别、年度、形成单位、密级等)、空间范围(地市点选或框选);
- 在线预览:扫描件与正文在线看,画面叠加水印,下载权限单独控制,阅览与下载都写审计;
- 借阅闭环:加入借阅车 → 提交申请 → 两级审批 → 借出 → 归还,超期未还在列表与首页同时提示;
- 数据范围:角色除功能权限外还带范围——局馆看全部,大队只看本全宗,查阅用户只看到公开目录。
馆藏 AI 助手:回答有出处
资料员和查阅用户可以直接用一句话提问,例如“馆内关于钨矿的成果资料有哪些”。助手先在当前账号可见的馆藏中检索,再把命中案卷的原文片段交给大模型作答:
- 依据馆藏作答:只根据检索到的片段回答,每条结论标注引用编号,点击即可回到对应案卷核对原文;
- 查不到就直说:可见范围内没有相关资料时直接告知并给出换词建议,不调用模型、不编造结论;
- 权限不越界:检索沿用全宗、密级与状态的数据范围,账号看不到的资料,助手也答不出;每次提问写入审计;
- 辅助著录:为单个案卷生成摘要、主题词与著录建议,结果只回填到表单,由资料员确认后再保存。
大模型与平台一同部署在局域网内,通过标准接口对接私有化部署的国产大模型,不依赖互联网。未接入模型时,助手自动切换为“检索摘录”模式,直接列出馆藏原文片段,其余功能不受影响。
AI 进入业务环节
除问答外,AI 还嵌入在资料员和编研人员每天用到的几个环节里,每一处都只给建议和出处,由人确认后生效:
| 环节 | 入口 | AI 做什么 |
|---|---|---|
| 检索 | 检索框旁「智能检索」 | 一句话拆成年度、地区、立档单位、资料类型、密级、比例尺与关键词,条件以标签显示,可逐项去掉或在高级条件中修改 |
| 著录 | 案卷著录弹窗「AI 辅助著录」 | 依据著录信息与电子文件正文生成内容摘要、关键字与著录建议,填入表单后由资料员确认保存 |
| 编研 | 专题详情「AI 编研初稿」 | 依据专题素材撰写综述初稿,每条事实标注引用编号,可修改后存为成果草稿 |
| 年报 | 档案年报「AI 起草」 | 依据当年统计数字起草年度说明,只用统计数字,核对后保存 |
| 随时提问 | 各页面右下角浮动按钮 | 不离开当前页面即可向馆藏提问,查看回答与引用卡片 |
地图检索
离线行政区划底图随包提供(省界与地级市边界),不调用外部瓦片服务,内网可用。按地市点选或在地图上框选,范围直接作为检索条件;结果按地市聚合数量,点开后进入对应案卷列表。地图可开全屏大窗口,图面与结果列表同屏对照。
底图按省提供,新增省份由坐标数据生成离线底图,不需要改前端代码。
部署与数据
- 轻依赖、全离线:后端以 Python 标准库为主,大图处理组件 Pillow 为可选项并随包提供离线安装包;前端文档解析库本地打包,不需要 Node 构建,运行时不访问 CDN,内网装机不会卡在依赖上;
- 单文件数据库:SQLite 单文件,备份即拷走,恢复即换回;数据库访问收在一处,只用 SQLite 与达梦 8 的公共子集,换库只改一处;
- 一个镜像起站:Docker 镜像加一条
docker compose up -d,可内网离线运行,也可在服务器侧统一反代; - AI 本地化部署:大模型为可选组件,与平台一同部署在局域网内;访问凭据只在服务器运行环境中配置,不写入配置文件、不下发到浏览器,问答与生成全部写审计;
- 审计:登录、检索、预览、下载、审批、导入导出与系统维护全部写审计日志,带账号、对象、详情与来源 IP。
与馆级全流程系统的分工
省级馆藏机构、需要成果/原始/实物三类资料全类型管理、低代码自定义、汇交电子文件智能校验、知识图谱与可视化大屏的,属于 zbook GDMS 地质资料管理系统 的范畴,产品线全貌见地质资料信息化整体解决方案。
本平台与馆级系统同源,覆盖接收、著录、检索、借阅、保管、库房、汇交、编研与实物利用的完整链路,面向处室与项目组资料室、市级馆藏、地勘单位资料岗。两者的著录口径与汇交标准一致,数据可以互转,不存在两套标准各管一段的问题;规模扩大后可按同一口径向馆级系统迁移。
演示与试用
演示环境中的组织、项目、案卷与电子文件均为虚构示例数据,仅用于说明界面与流程。演示账号由业务顾问开通并陪同讲解,不在页面公布,需要体验的可通过预约演示留言,说明单位类型、资料门类与关注环节,我们会按贵单位的档号规则准备一份对应的配置与样例数据。
正式部署时按本单位门类、著录字段与档号规则重新建库,不沿用演示数据;也可在私有化环境中先导入 3 至 5 卷真实案卷试跑,验证报盘映射、权限范围与借阅流程后再全面铺开。