本文已脱敏:不出现客户名称、不引用真实档案内容、不披露数据量与效率指标,仅记录实施范围与功能落地情况。
项目概况
客户是一家农牧食品行业的 500 强集团企业,组织形态是典型的总部 + 多法人:集团总部下辖 6 家法人主体,同时有 16 个在建项目在推进。
这种结构在档案管理上的难处很好理解——总部档案室要统口径、要能出全集团的账;各法人主体要按自己的经营需要管档案;项目档案又只属于某个项目,验收之后要能整包移交。三套逻辑压在同一个库里,靠 Excel 台账和共享文件夹是对不上的。
实施范围
| 维度 | 落地配置 |
|---|---|
| 法人主体 | 6 家(集团母公司 + 下属公司) |
| 在建项目 | 16 个 |
| 档案门类 | 46 个(通用包 44 个基础上按行业扩展) |
| 责任部门 | 11 个 |
| 数据范围 | 集团 / 区域事业部 / 法人主体 / 项目 四级 |
| 部署方式 | 私有化部署,Docker 起站,数据留在客户机房 |
门类比通用包多了两个,是因为农牧食品行业有自己特有的档案类型:基地与养殖场的手续、检疫与质量记录一类,套不进文书或工程的通用口径,就单独建了门类。
上线做了什么
1. 先把组织模型立起来
按「法人主体 → 项目 → 档案门类」建库,档案著录时同时记录主档法人与所属项目。这一步做完,后面所有统计才有可能按主体、按项目切分。
2. 存量数据批量进来
存量著录走 Excel / CSV 批量导入,先跑预演校验再落库:门类编码不存在、部门对不上、必填缺失都会在预演阶段逐行提示,同名档案默认跳过。分批导入,每批控制在 2000 行内,出错好回退。
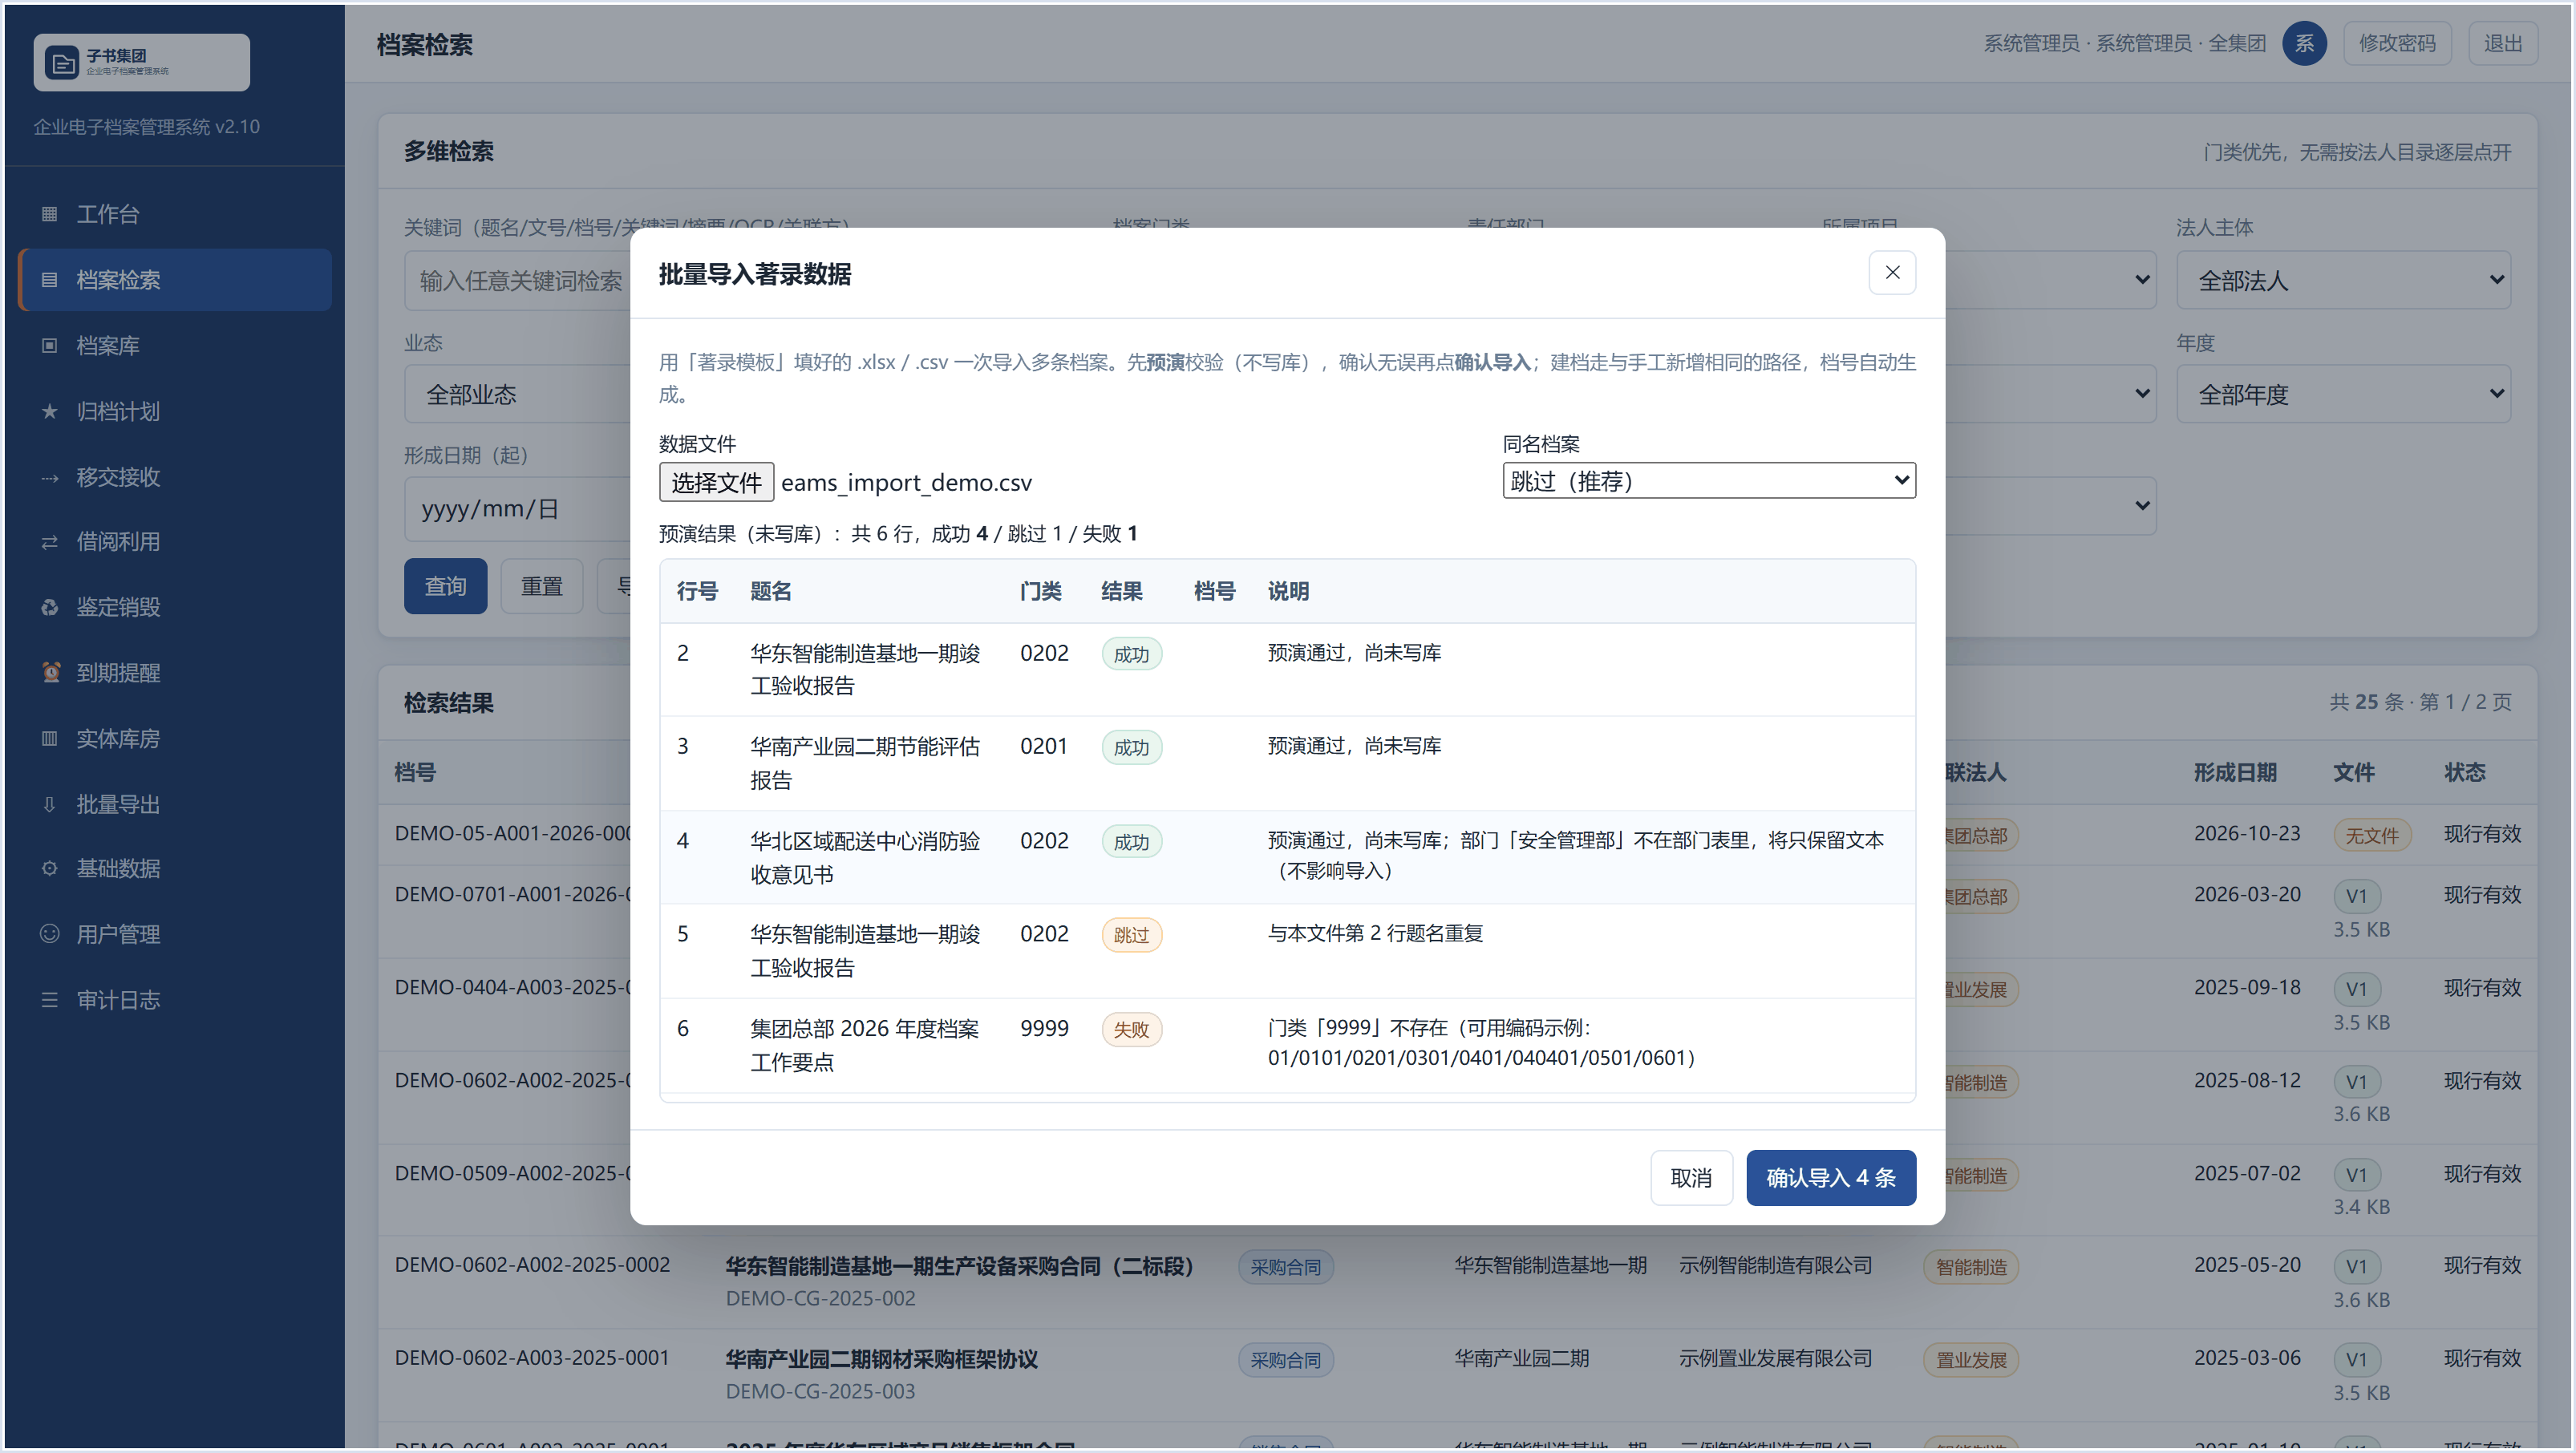
预演阶段的结果列表:先看清楚,再落库
3. 归档计划替代催办
年度归档按计划下达,拆成任务派到 11 个部门与各项目,责任人填报后提交,档案员审核入库。提交与审核各留一条记录,进度在列表里可查。
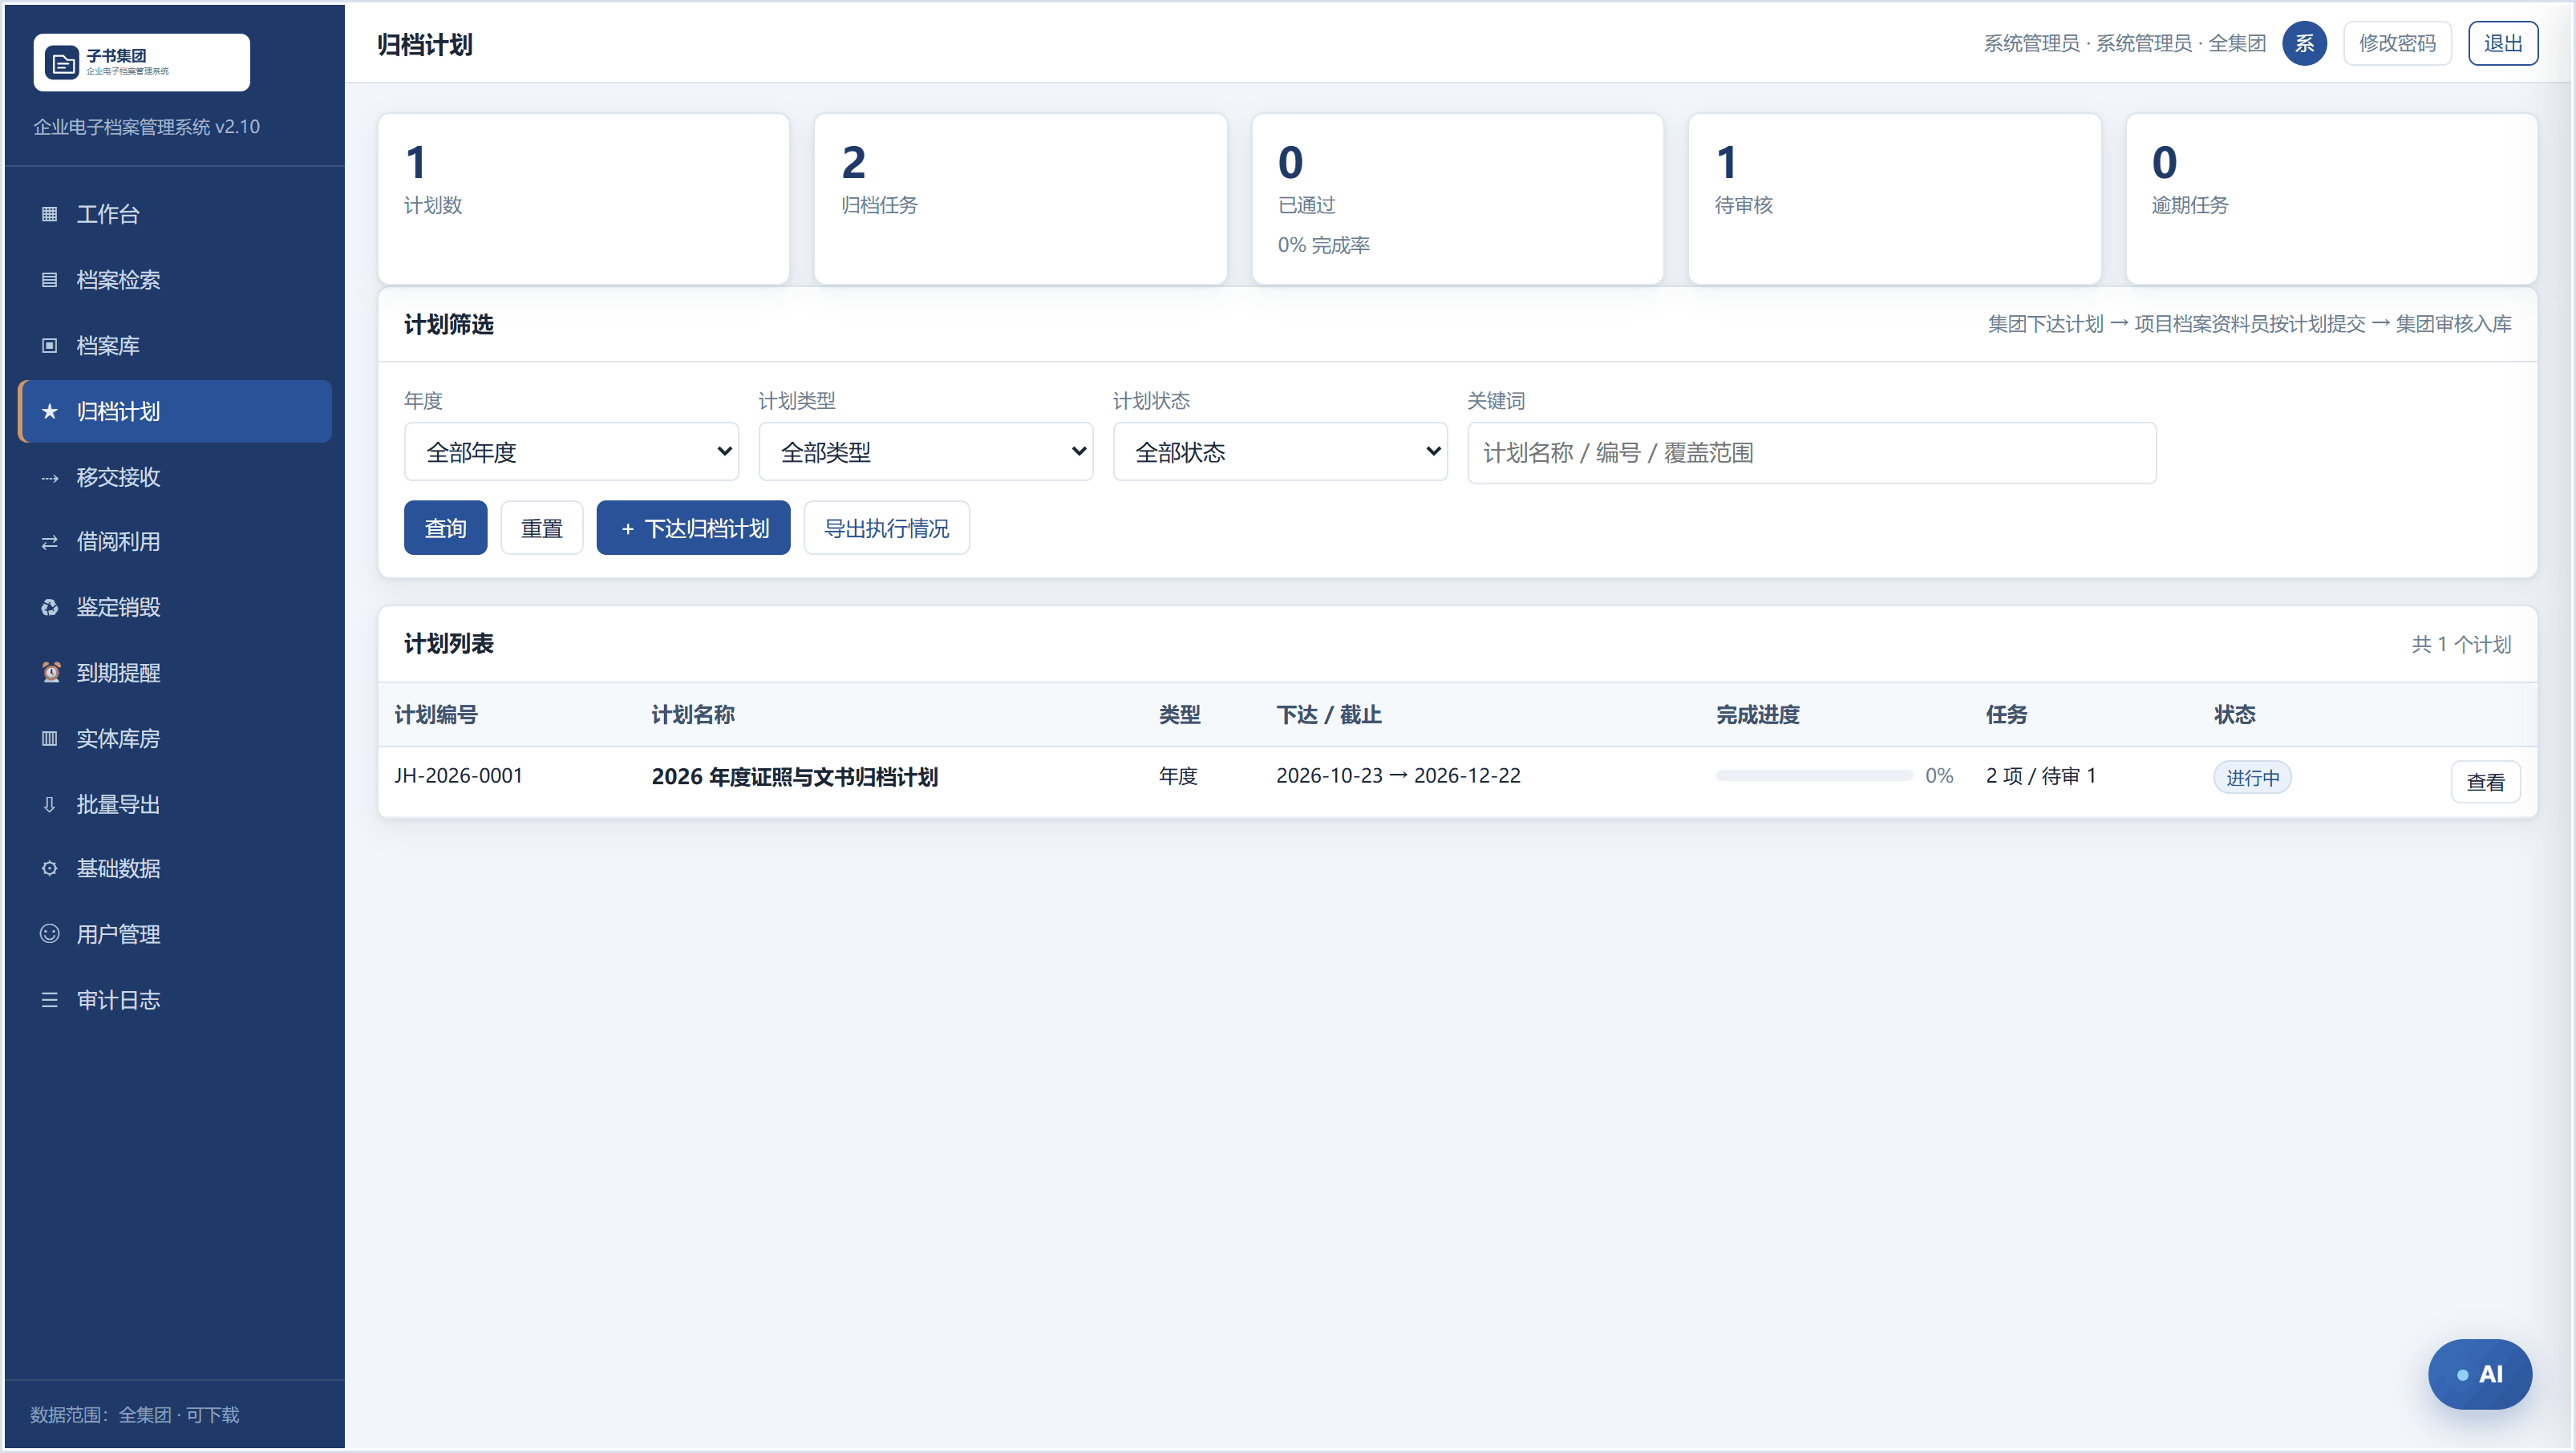
归档计划:任务状态与完成期限同屏,谁还没交一眼能看出来
4. 借阅、下载、审计一起上
借阅走「申请 → 审批 → 借出 → 归还」,借阅事由、利用方式、期限、份数逐项登记;下载次数可查;登录、检索、借阅、下载、导入、导出、增删改全部进审计日志,带账号、对象、详情与 IP。
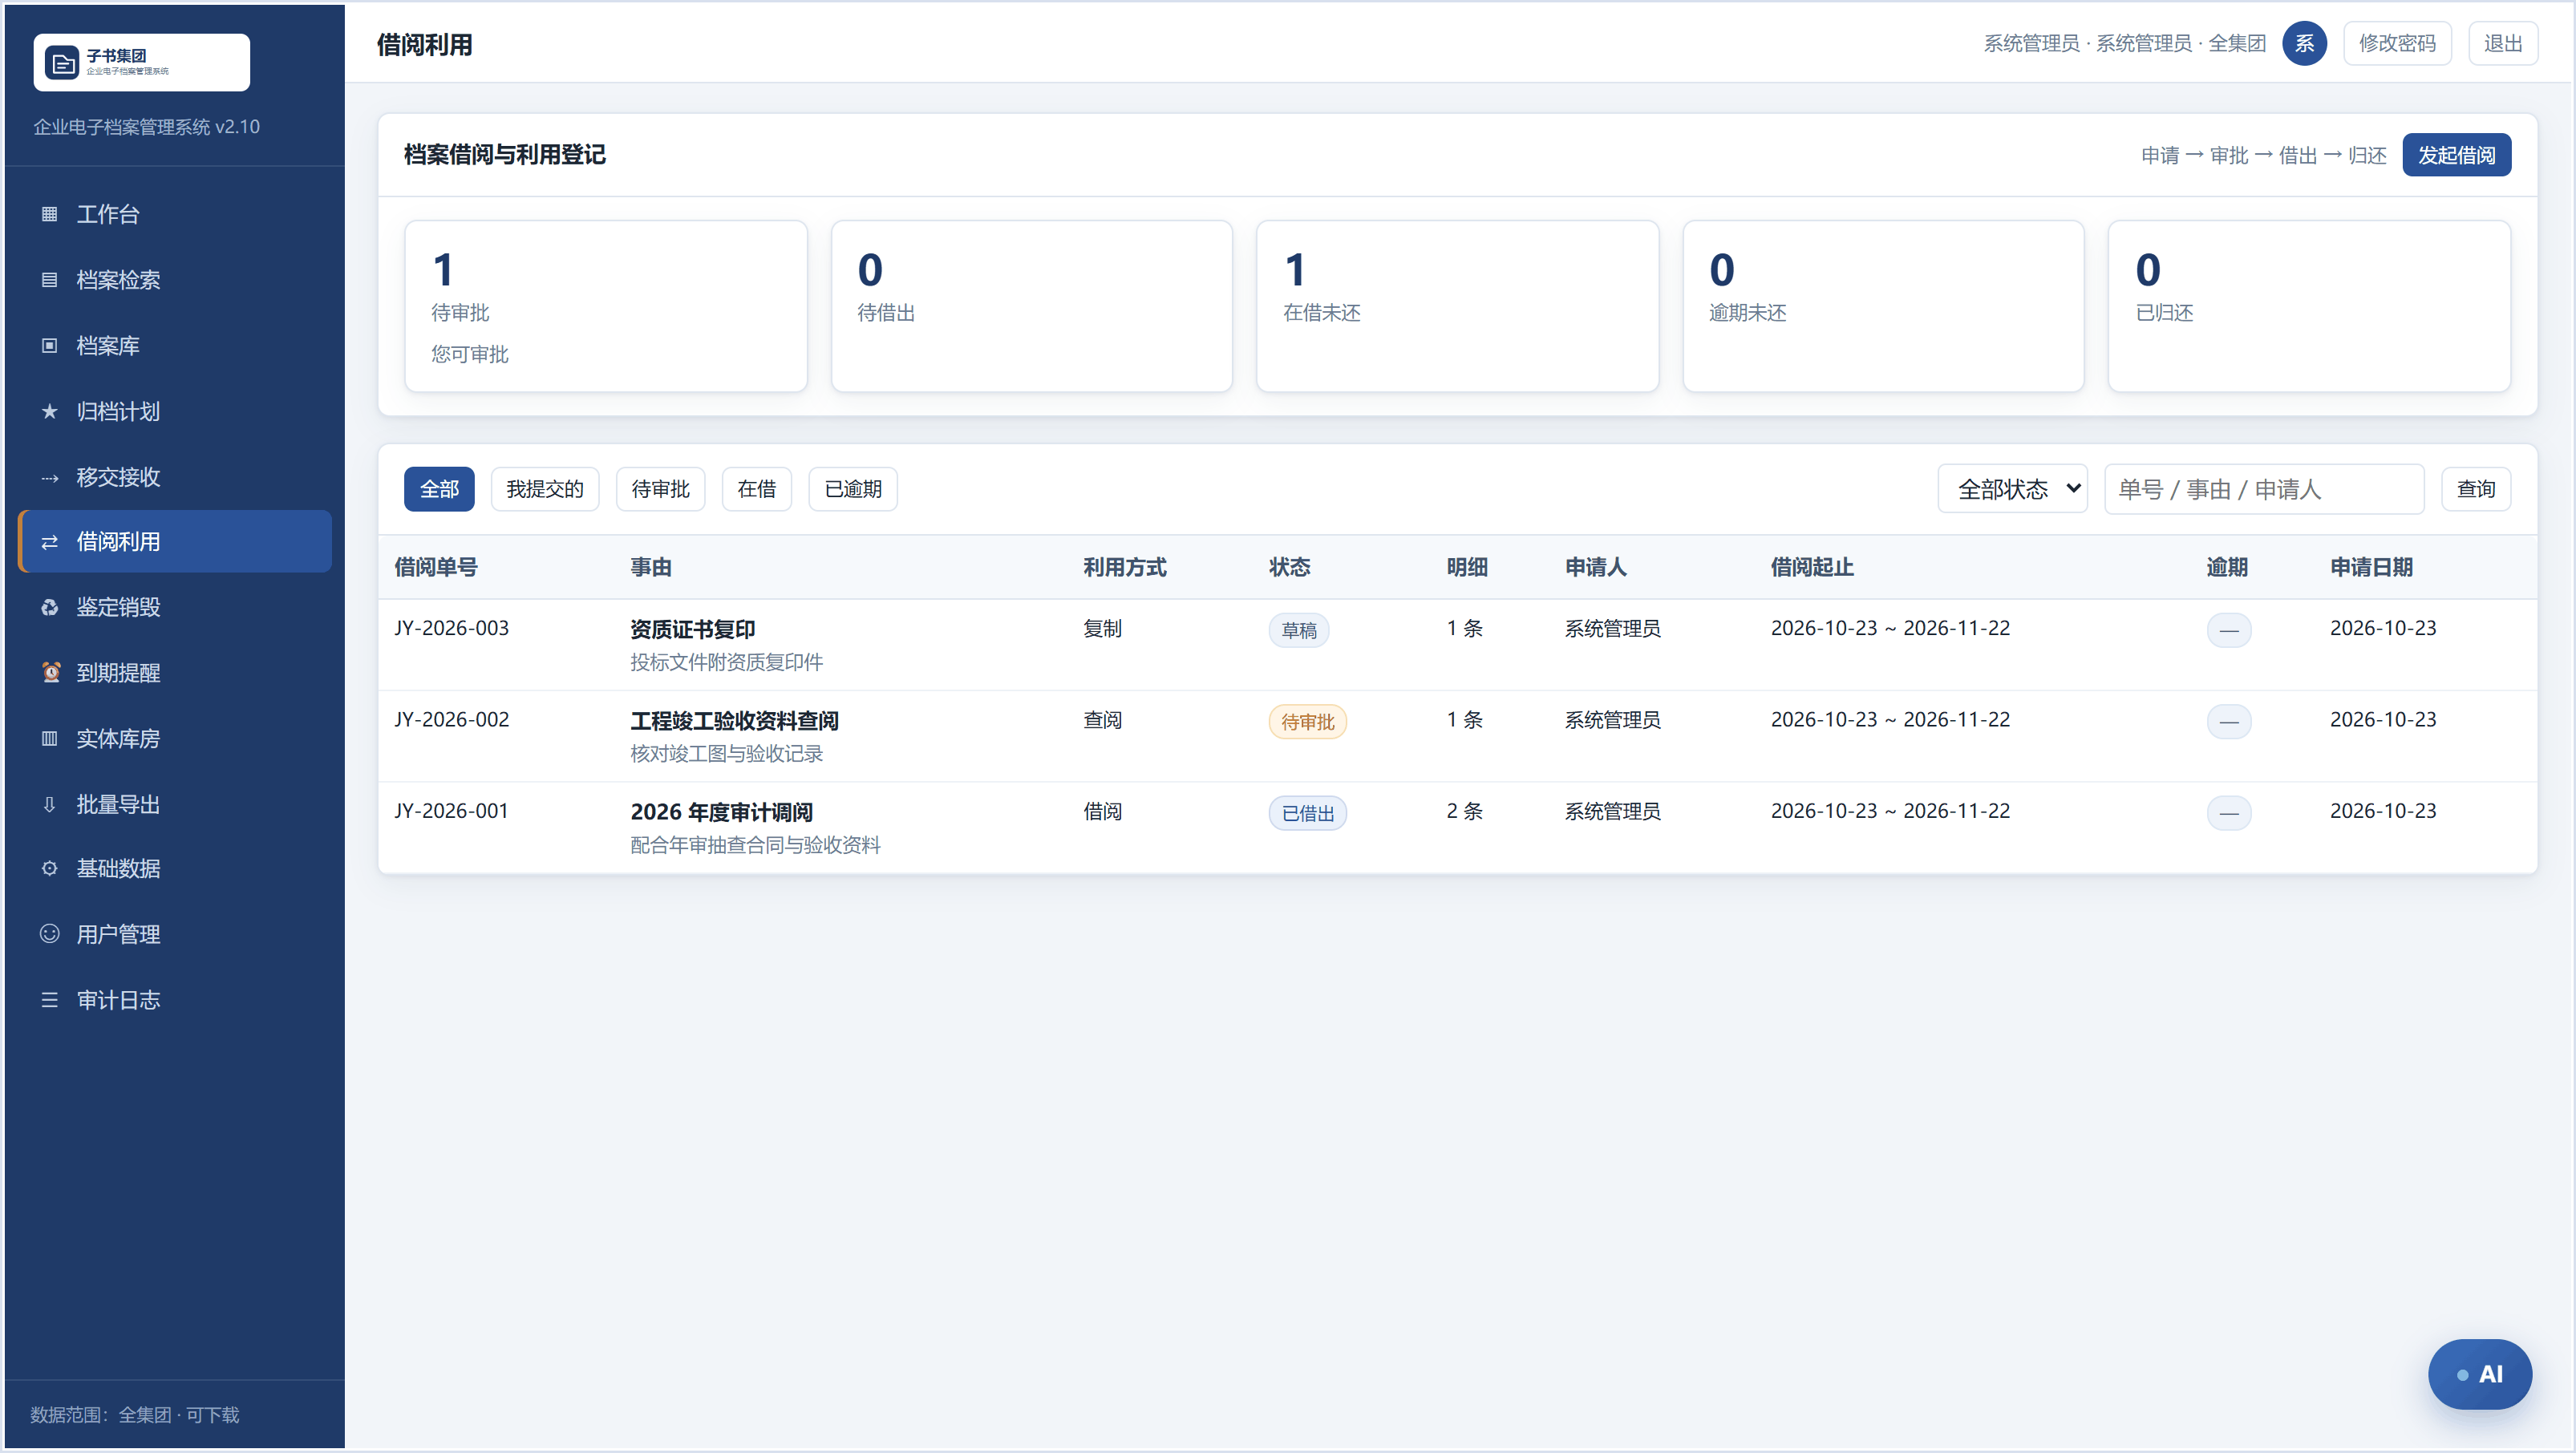
借阅利用:四类状态与借阅期限集中在一个列表
5. 纸质档案落到位
纸质原件按库房 → 排架 → 柜 → 层 → 位维护位置,上架下架、出入库进台账;温湿度记录与「30 天未出入库」提醒,用来发现长期没人动的区域。
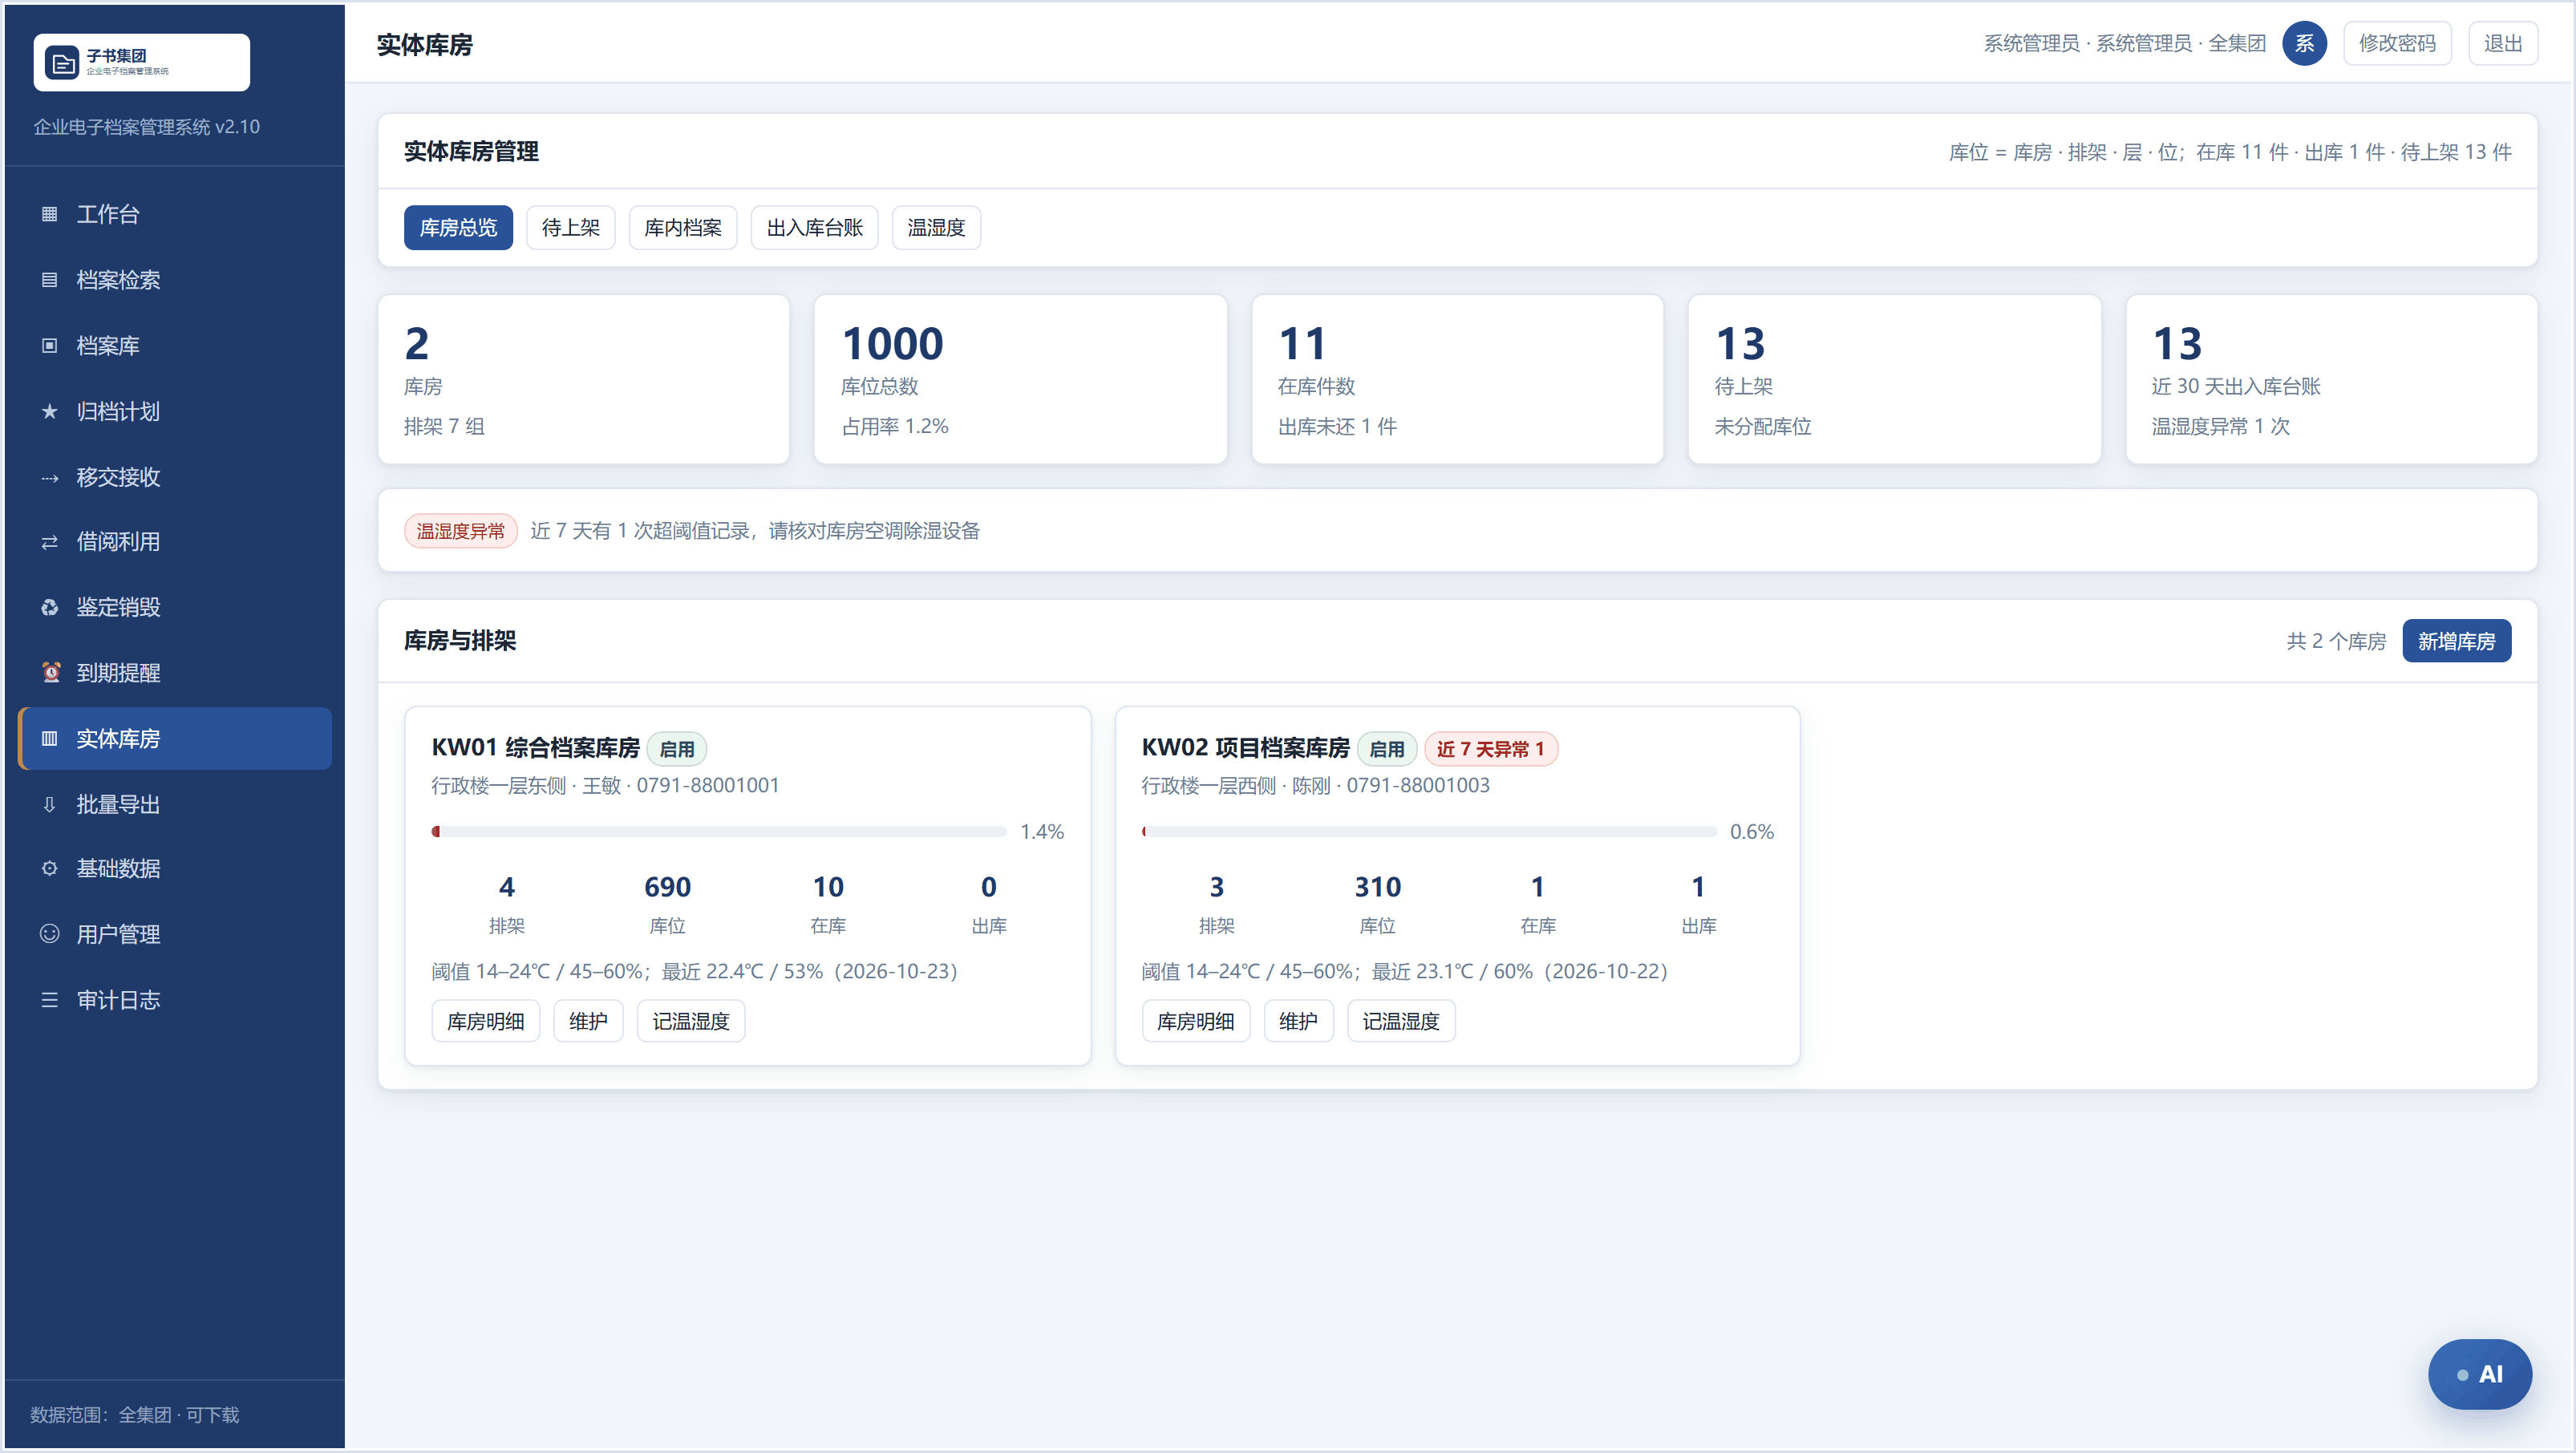
实体库房:电子与纸质一份档案一处对应
6. AI 助手默认不联网
AI 档案助手默认走本地规则引擎,断网可用、数据不出内网;回答会标注所用引擎与判断依据。集团合规口径对「档案正文出内网」很敏感,这一点在方案阶段就被明确要求。
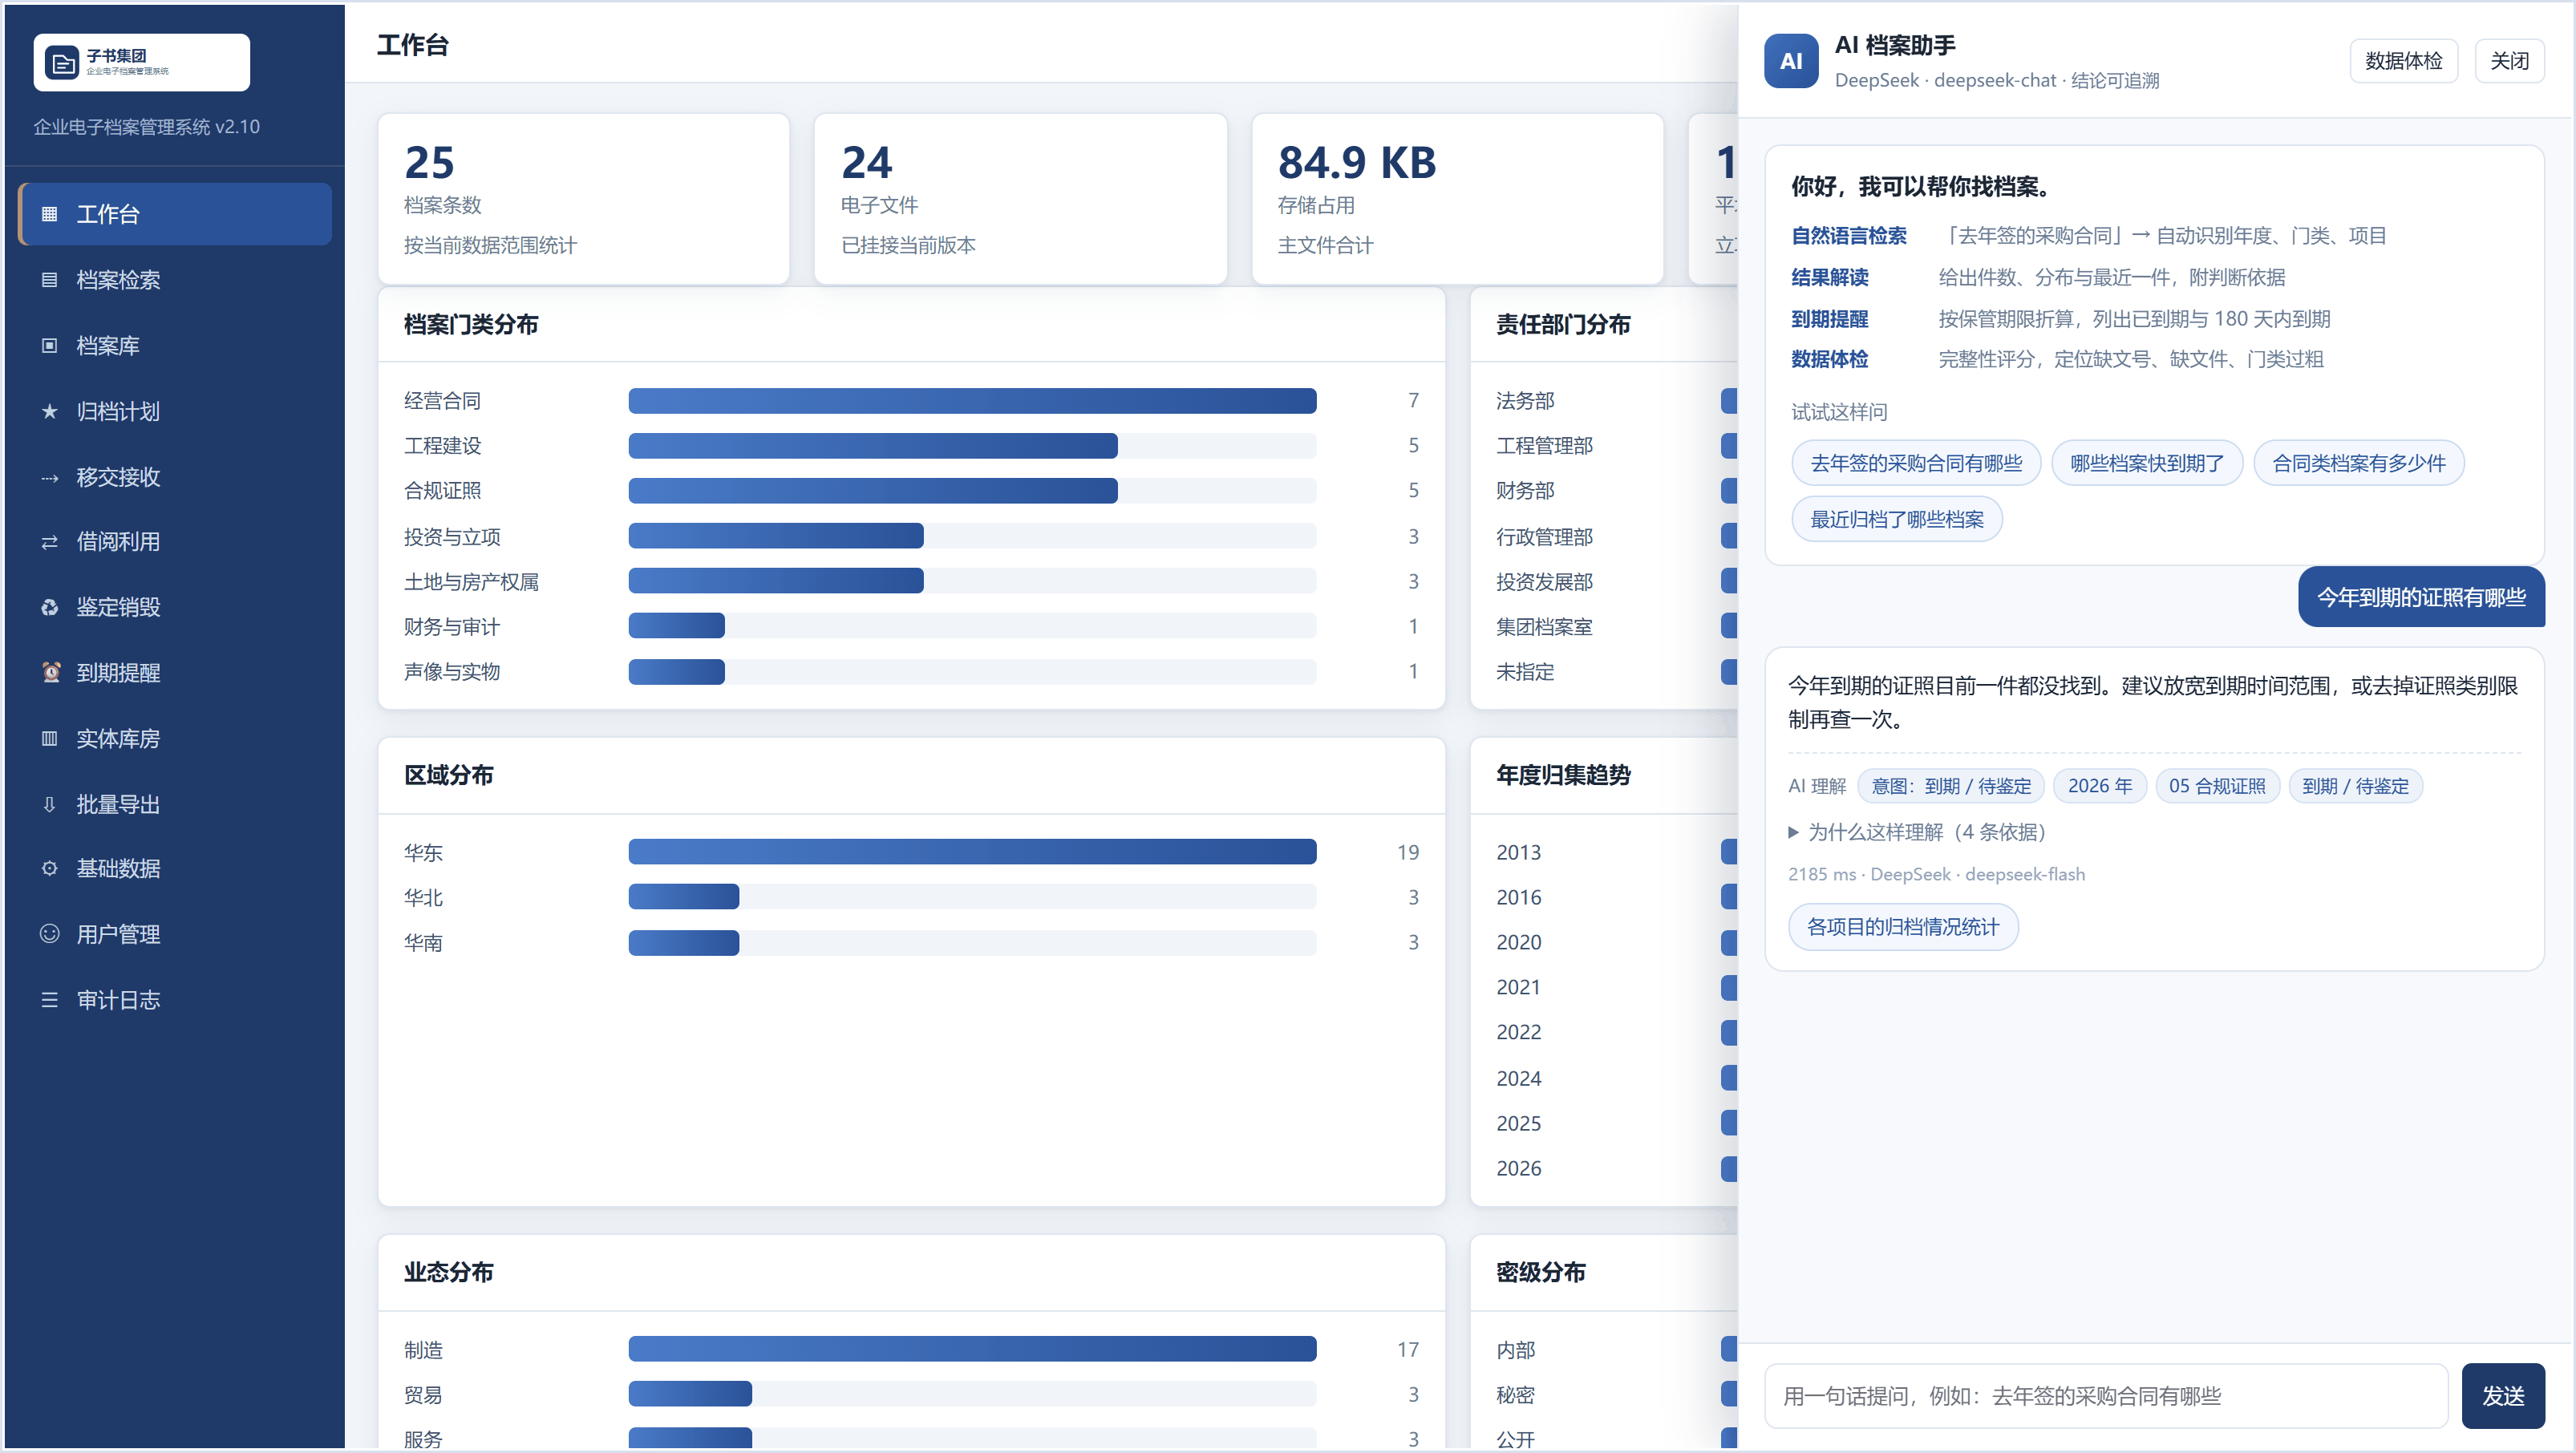
AI 档案助手:结论下方列出识别到的实体与依据
交付物
- Docker 镜像与部署说明,客户机房私有化运行;
- 46 个门类、11 个部门的编码与字典初始化;
- 账号体系与四级数据范围配置;
- 管理员培训一次;
- 《使用说明》49 页(含 35 幅操作图)与《运维手册》23 页。
这次的三条经验
- 先定门类,再导数据。门类编码一旦被数据引用,修改要重新映射,返工成本远高于前期多花半天确认;
- 数据范围要在建账号前想清楚。范围配错不会报错,但会让人看到不该看的档案;
- 导入一律先预演。存量数据的脏是常态,能在预演阶段暴露的问题,不要留到落库之后。
相关
- 产品页:企业电子档案管理系统 zbook EAMS 1.0
- 技术取舍:零依赖 + Docker:一周上线一套企业档案系统
- 建库方法:集团企业档案怎么管:法人—项目—门类三层归档实践
- 需要评估同类项目,联系我们。
说明:文中截图取自演示环境,数据为虚构示例企业,与客户真实数据无关。